参考:
强化学习概述
强化学习是机器通过与环境交互来实现目标的一种方法。
Agent和环境之间包含如下关系:
- 感知:感受环境状态(也称之为观测)
- 决策:依据当前状态计算出达到目标需要采取的动作
- 奖励:环境给予反馈
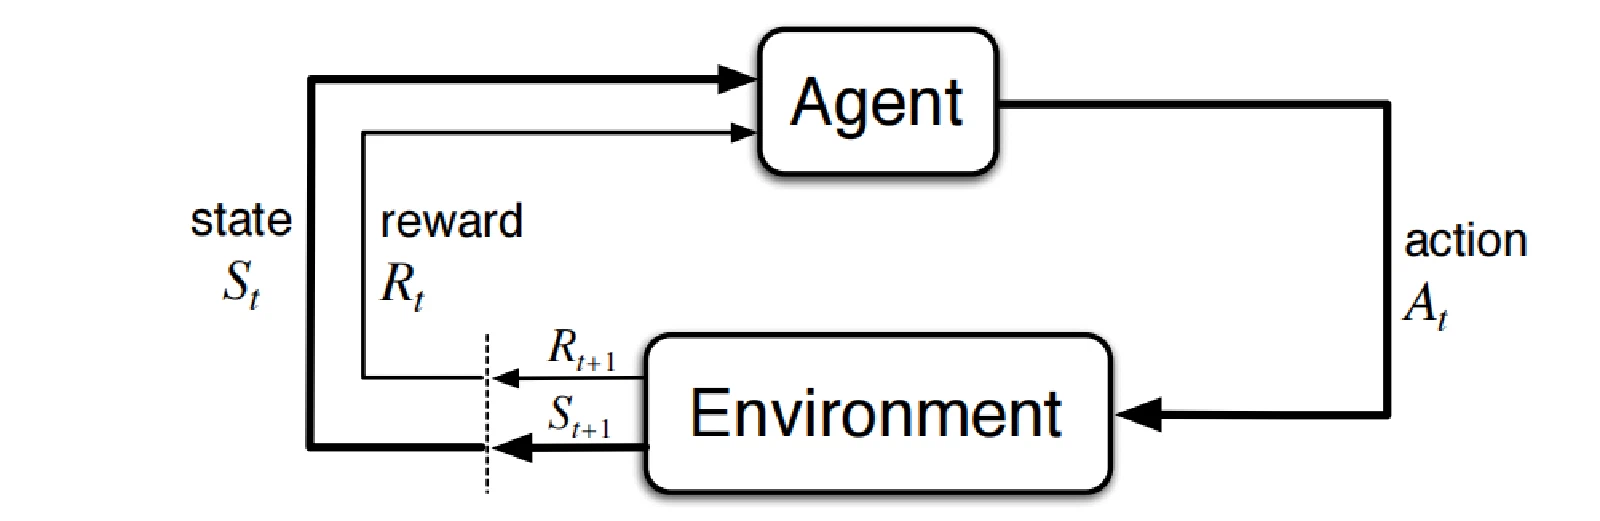
每一轮交互中,Agent首先感知环境所处的state,然后决策出本轮的action,并应用到环境中。环境产生即时奖励并产生状态转移,Agent根据奖励修改其决策策略。循环直到达到终止状态,得到一个策略,该策略能根据环境状态和奖励,自主做出比较好的决策。
马尔可夫决策过程MDP
一个不确定的环境中,连续地做出一系列决策,而每个决策不仅影响当前的得失,还会影响未来的处境。马尔可夫决策过程(Markov Decision Process, MDP)正是为这类"序贯决策问题"建立的统一数学框架。
形式化定义
一个 MDP 由五元组 $(S, A, P, R, \gamma)$ 定义:
| 符号 | 名称 | 含义 |
|---|---|---|
| $S$ | 状态集合(State Space) | 环境所有可能状态的集合 |
| $A$ | 动作集合(Action Space) | 智能体可选动作的集合(可记 $A(s)$ 表示状态 $s$ 下可选动作) |
| $P$ | 状态转移概率(Transition Probability) | $P(s’ \mid s, a)$:在状态 $s$ 执行动作 $a$ 后转移到 $s’$ 的概率 |
| $R$ | 奖励函数(Reward Function) | $R(s, a, s’)$ 或 $R(s, a)$:转移后获得的即时奖励 |
| $\gamma$ | 折扣因子(Discount Factor) | $0 \le \gamma \le 1$,衡量未来奖励的当前价值 |
马尔可夫性质
MDP 的核心假设是马尔可夫性质(Markov Property):
$$P(s_{t+1} \mid s_t, a_t, s_{t-1}, a_{t-1}, \dots, s_0, a_0) = P(s_{t+1} \mid s_t, a_t)$$即:未来只取决于当前状态和动作,与历史无关。通俗地说,“知道现在,就等于知道了过去的一切”。
注:若现实问题不满足马尔可夫性质,通常可以通过扩充状态(把历史信息编码进状态)使其满足。
智能体–环境交互循环
MDP 的决策过程按离散时间步进行:
时刻 t:
  1. 智能体观察状态 s_t
  2. 智能体选择动作 a_t
  3. 环境依 P(·|s_t, a_t) 转移到新状态 s_{t+1}
  4. 智能体收到奖励 r_{t+1}
  5. t ← t+1,重复
由此产生一条轨迹(trajectory):
$$\tau = (s_0, a_0, r_1, s_1, a_1, r_2, s_2, \dots)$$智能体的目标:选择动作使长期累计回报最大化。
状态和观测
世界状态的完整描述s。观测o是对一个状态的部分描述,可能遗漏。
强化学习有时候用符号s代表状态,有些地方也会写作观测符号o。 尤其是,当智能体在决定采取什么动作的时候,符号上的表示按理动作是基于状态的, 但实际上,动作是基于观测的,因为智能体并不能知道状态(只能通过观测了解状态)。
动作空间
有效动作的集合。
回报和价值
回报(Return)/ 奖励(Reward)
强化学习中,奖励函数$R$非常重要。它由当前状态、已经执行的动作和下一步的状态共同决定。
$$r_t = R(s_t, a_t, s_{t+1})$$有的时候会改为只依赖当前状态$r_t =R(s_t)$或状态动作对$r_t =R(s_t, a_t)$。
有一种回报是有限视野无折扣回报,另一种是无限视野折扣回报。顾名思义,前者只看有限步、不打折,后者指的是智能体曾经获得的全部奖励之和, 但是奖励会因为获得的时间不同而衰减。
这里后面都以无限视野折扣回报为例,从时刻 $t$ 开始的折扣累计回报定义为:
$$G_t = r_{t+1} + \gamma^1 r_{t+2} + \gamma^2 r_{t+3} + \cdots = \sum_{k=0}^{\infty} \gamma^k r_{t+k+1}$$折扣因子 $\gamma$ 的作用:0-1的数,表示未来的奖励打几折。
- $\gamma = 0$:完全"近视",只看眼前奖励;
- $\gamma \to 1$:重视长远利益;
- $\gamma < 1$ 还能保证无限期问题中回报收敛(有界奖励时)。
策略(Policy)
Agent下一步执行什么动作的规则。
- 确定的表示为$\mu$:$a_t = \mu (s_t)$
- 不确定的表示为$\pi$:$a_t = \pi (·|s_t)$
因为策略本质上就是智能体的大脑,所以很多时候“策略”和“智能体”这两个名词经常互换,例如我们会说:“策略的目的是最大化奖励”。
在深度强化学习中,我们处理的是参数化的策略:策略的输出依赖于一系列计算函数, 而这些函数又依赖于参数(例如神经网络的权重和偏差),所以我们可以通过一些优化算法改变智能体的的行为。我们经常把这些策略的参数写作$\theta$或者$\phi$ ,然后把它写在策略的下标上来强调两者的联系。
$$a_t = \mu_{\theta}(s_t) $$$$a_t \sim \pi_{\theta}(\cdot | s_t)$$确定性策略
$\mu(s)→a$:输入状态 s ,网络前向一次,得出一个确定的动作。
随机策略
$π(⋅∣s)→一个关于 a 的概率分布$:网络前向输出的不是动作本身,而是分布的参数,然后从这个分布里采样得到动作。
价值函数(Value Functions)
回报 $G_t$ 是随机变量,且依赖出发状态,没法直接拿来比较。对于随机变量,我们一般是进行最大化期望值的方式处理,此外,回报的期望还取决于初始状态,因此,对它取期望、按状态分类,得到价值函数:
$$V^{\pi}(s) = \mathbb{E}_{\pi}\left[ G_t \,\middle|\, s_t = s \right]$$在策略 $\pi$ 下,状态 $s$ 的价值 = 从 $s$ 出发遵循 $\pi$ 的期望回报。
按状态分类就够了,不用按整条历史分类,是因为马尔可夫性质:从 $s$ 出发的未来只取决于 $s$,与怎么走到 $s$ 无关。马尔可夫性质保证了只需要由同一个状态出发,能确保未来的所有统计规律都是相同的。
动作价值函数(Q 函数)
假设已经把所有状态的$V^\pi(s)$ 全部算出,现在我们的目标是在状态$s$中想要选择下一步,那应该如何做到呢?要回答这个问题,需要对每个候选动作 $a$分别评估:在状态 $s$ 强制执行动作 $a$,之后遵循 $\pi$,能获得的期望回报。
$$Q^{\pi}(s, a) = \mathbb{E}_{\pi}\left[ G_t \,\middle|\, s_t = s,\; a_t = a \right]$$也就是在这里选择了$a$那么我们的期望回报是多少。
那么,$V$ 是 $Q$ 按策略的加权平均:
$$V^{\pi}(s) = \sum_{a} \pi(a \mid s)\, Q^{\pi}(s, a)$$若 $\pi$ 是确定性策略 $\pi(s)=a^* $,则 $V^\pi(s) = Q^\pi(s, a^*)$。
整理好了。结构调整为:先立"自我递归"这个核心性质 → 推导递归式 → 用全概率公式 + 马尔可夫性质把 $V^\pi$ 引出来 → 展开三层期望 → 落到标准形式 → 最后用一个小例子讲清"方程组可以直接解"和"递归的价值"。原来最后那句没展开的断言,补了具体数字。
Bellman 期望方程
强化学习的目标说起来很简单:让智能体在环境里行动,拿到的累计奖励越多越好。我们把这个"累计奖励"叫做回报,记作 $G_t$:
$$G_t = r_{t+1} + \gamma r_{t+2} + \gamma^2 r_{t+3} + \cdots$$麻烦显而易见:这个求和是无穷的。只要游戏不结束,后面就有无穷多项。你没法让计算机把无穷个数一个一个加起来。
核心性质:自我递归
要解决此问题,需要观察$G_t$,注意到把 $G_t$ 的定义拆出第一项:
$$G_t = r_{t+1} + \gamma\,\underbrace{(r_{t+2} + \gamma r_{t+3} + \cdots)}_{G_{t+1}}$$即:
$$G_t = r_{t+1} + \gamma G_{t+1}$$今天的回报 = 眼前这一步的奖励 + 打折后的明天回报。
回报出现在了它自己的定义里——这就是自我递归。无穷级数的问题还没解决,但我们已经把它压缩成了一条 recurrence(递推式)。
从回报的递归到价值的递归
回报 $G_t$ 有一个缺点:它是随机的。
同一个状态下,智能体这次可能选动作甲、下次可能选动作乙(策略本身带随机性);环境的转移也带有随机性。所以 $G_t$ 每次roll出来都不一样,没法直接拿来当"这个状态好不好"的度量。
因此对 $G_t = r_{t+1} + \gamma G_{t+1}$ 两边取条件期望(条件 $s_t = s$),期望是线性的,可以拆开发配到每一项上:
$$\underbrace{\mathbb{E}_{\pi}[G_t \mid s_t = s]}_{V^\pi(s)} = \mathbb{E}_{\pi}[r_{t+1} \mid s_t = s] + \gamma\, \mathbb{E}_{\pi}[G_{t+1} \mid s_t = s]$$麻烦在最后一项
$$\mathbb{E}_{\pi}[G_{t+1}\mid s_t = s]$$目标是想办法把它也变成某个状态的价值,让等式右边出现 $V^\pi$。
工具是全概率公式:
$$\mathbb{E}[X] = \mathbb{E}\big[\, \mathbb{E}[X \mid Y] \,\big]$$取 $X = G_{t+1}$,$Y = s_{t+1}$,也就是先固定下一步到了哪个状态,算该情况下的平均回报;再对所有可能的下一状态加权平均:
$$\mathbb{E}_{\pi}[G_{t+1} \mid s_t = s] = \mathbb{E}_{\pi}\Big[ \underbrace{\mathbb{E}_{\pi}[G_{t+1} \mid s_t = s,\; s_{t+1}]}_{\text{内层期望}} \,\Big|\, s_t = s \Big]$$看内层期望。它的条件是既知道现在 $s_t = s$,又知道下一步到了 $s_{t+1}$。
这里要用到马尔可夫性质:一旦 $s_{t+1}$ 确定了,$G_{t+1}$ 的分布就和过去(包括 $s_t$)无关了——未来只取决于现在。所以条件里的 $s_t = s$ 是多余信息:
$$\mathbb{E}_{\pi}[G_{t+1} \mid s_t = s,\; s_{t+1}] = \mathbb{E}_{\pi}[G_{t+1} \mid s_{t+1}] $$右侧的公式正好是价值函数:
$$\mathbb{E}_{\pi}[G_{t+1} \mid s_{t+1}] = V^\pi(s_{t+1})$$代回外层:
$$\mathbb{E}_{\pi}[G_{t+1} \mid s_t = s] = \mathbb{E}_{\pi}\big[ V^\pi(s_{t+1}) \,\big|\, s_t = s \big]$$加上一开始的
$${V^\pi(s)} = \mathbb{E}_{\pi}[r_{t+1} \mid s_t = s] + \gamma\, \mathbb{E}_{\pi}[G_{t+1} \mid s_t = s]$$由此得到了价值的递归公式:
$$V^\pi(s) = \underbrace{\mathbb{E}_{\pi}[r_{t+1}|s_t=s]}_{\text{眼前这一步平均拿多少}} + \gamma \underbrace{\mathbb{E}_{\pi}[V^\pi(s_{t+1})|s_t=s]}_{\text{未来平均值多少}}$$$V^\pi$ 出现在了等号两边。由此得到了价值函数的递推。
期望号在平均什么?
上面的式子已经是对的,但右边还挂着一个期望号 $\mathbb{E}_\pi$。它要对什么取平均?答案是对从 $s$ 出发一步之内的所有随机性。
从状态 $s$ 到算出奖励 $r$ 和下一状态 $s’$,中间有三个随机环节:
状态 s ──①──> 动作 a ──②──> 下一状态 s' ──③──> 奖励 r
    策略随机        环境转移随机     奖励可能随机
   π(a|s) 决定    P(s'|s,a) 决定
期望在离散情形下就是加权平均,三个随机环节,就套三层:
- 第①层:策略选动作。 在状态 $s$,策略以概率 $\pi(a \mid s)$ 选动作 $a$。→ 对所有可能的 $a$ 求和,权重 $\pi(a \mid s)$;
- 第②层:环境转移。 选定动作后,环境以概率 $P(s’ \mid s, a)$ 把你送到下一状态 $s’$。→ 对所有可能的 $s’$ 求和,权重 $P(s’ \mid s, a)$;
- 第③层:奖励发放。 奖励本身也可能随机。习惯上我们把 $R(s, a, s’)$ 直接定义成这一步的平均奖励,把这一层的期望吸收进 $R$。
于是期望展开为:
$$V^{\pi}(s) = \underbrace{\sum_{a} \pi(a \mid s)}_{\text{第①层:策略选动作}} \; \underbrace{\sum_{s'} P(s' \mid s, a)}_{\text{第②层:环境转移}} \; \underbrace{\Big[ R(s,a,s') + \gamma V^{\pi}(s') \Big]}_{\text{每种结果下的收获}}$$Bellman 期望方程的标准形式
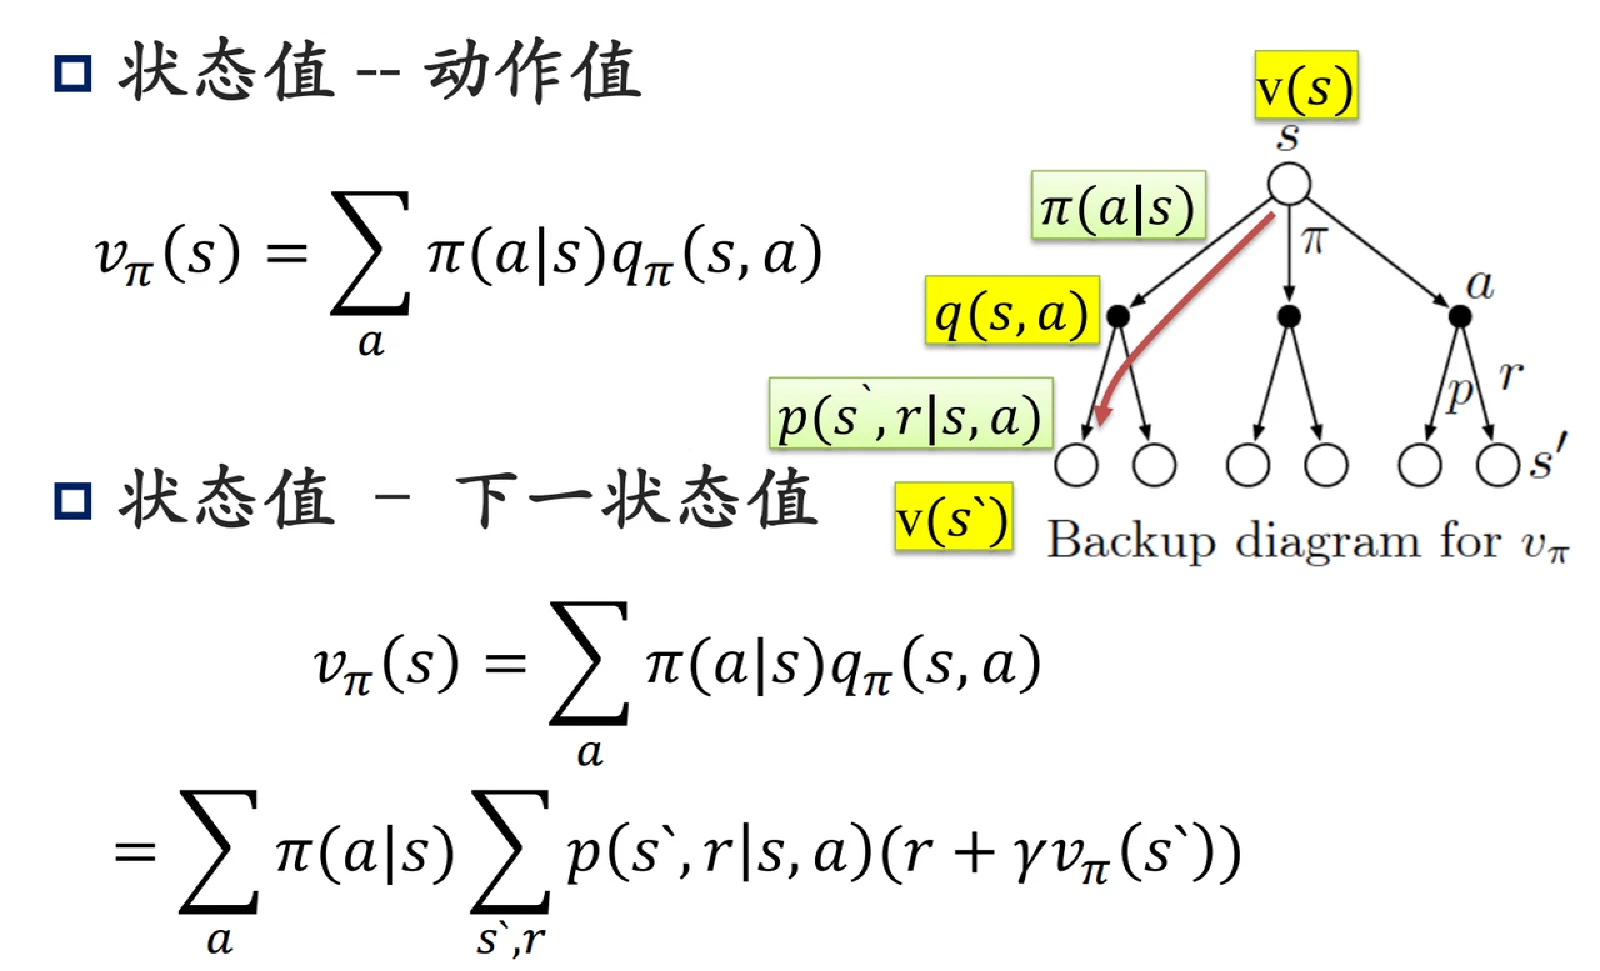
把上面的结果写出来,就是教科书上的 Bellman 期望方程,状态价值版:
$$V^{\pi}(s) = \sum_{a} \pi(a \mid s) \sum_{s'} P(s' \mid s, a)\left[ R(s,a,s') + \gamma V^{\pi}(s') \right]$$动作价值版就是先固定第一步$a$,之后仍然按照$\pi$行动:
$$Q^{\pi}(s, a) = \sum_{s'} P(s' \mid s, a)\left[ R(s,a,s') + \gamma \sum_{a'} \pi(a' \mid s')\, Q^{\pi}(s', a') \right]$$当前价值 = 即时奖励 + 折扣后的后继价值。
例子
Q:右边含 $V(s’)$、左边是 $V(s)$,这怎么算?
A:每个状态贡献一个方程,$N$ 个状态就是 $N$ 个方程、$N$ 个未知数的线性方程组,可以直接解。
来看一个最小的例子。假设整个世界只有 2 个状态 A、B,策略、转移、奖励全部确定,$\gamma = 0.5$:
- 在 A:拿奖励 1,跳到 B;
- 在 B:拿奖励 2,跳回 A。
没有随机性,求和号全部消失,Bellman 方程退化成:
$$V(A) = 1 + 0.5\,V(B), \qquad V(B) = 2 + 0.5\,V(A)$$2 个未知数,2 个方程。把第二式代入第一式:
$$V(A) = 1 + 0.5\big(2 + 0.5\,V(A)\big) = 2 + 0.25\,V(A) \;\Rightarrow\; 0.75·V(A) = 2 \;\Rightarrow\; V(A) = \frac{8}{3}$$回代:
$$V(B) = 2 + 0.5 \times \frac{8}{3} = \frac{10}{3}$$用无限求和验证。从 A 出发,轨迹是 A→B→A→B→…,奖励序列是 $1, 2, 1, 2, \dots$:
$$G = 1 + 0.5 \times 2 + 0.25 \times 1 + 0.125 \times 2 + \cdots$$每两步打包:$(1+1) + 0.25\times(1+1) + 0.25^2\times(1+1) + \cdots = 2 \times \dfrac{1}{1 - 0.25} = \dfrac{8}{3}$
也就是说,通过无穷求和的方法和方程组求解是一样的。
不动点方程
把 Bellman 方程抽象地看。不管右边那一堆求和细节,把"右边整个操作"记作一个算子 $T$,方程就是
$$V^\pi = T(V^\pi)$$这样的方程叫不动点方程。如
$$x = 0.5x + 1$$$x$(或 $V^\pi$),被算子 $T$ 作用之后不动——它就是 $T$ 的不动点。这些不动点方程的解法就是随便猜一个初值,然后反复代入右边。如初值取 $x_0 = 0$:
$$x_1 = 0.5\times 0 + 1 = 1, \quad x_2 = 0.5\times 1 + 1 = 1.5, \quad x_3 = 1.75, \quad x_4 = 1.875, \;\dots$$肉眼可见地逼近精确解 $x = 2$。
同样地,Bellman 迭代只是主角从数 $x$ 换成了函数 $V$:给所有状态随便赋初值(比如 $V_0(s) = 0$),然后反复执行
$$V_{k+1}(s) \;\leftarrow\; \mathbb{E}\big[\, r + \gamma V_k(s') \,\big|\, s \,\big]$$每次迭代误差缩小$\gamma$倍,最终会收敛。
后面要讲到的几乎所有的强化学习算法,都只是这同一个式子在不同限制下的解决方式:
- 直接解方程:式子摆在这,$N$ 元线性方程组,理论上有精确解。但需要事先知道环境的完整模型($P$ 和 $R$),且 $N$ 一大求解代价是 $O(N^3)$,实际很少这么干。
- 策略评估:知道模型,但不想解方程组 → 等号改成赋值,反复迭代到收敛。这就是动态规划里的策略评估。
- 值迭代:迭代时把"按策略取期望"换成"对动作取 max"——$;V(s) \leftarrow \max_a \mathbb{E}[r + \gamma V(s’)]$,收敛到的就是最优价值 $V^*$。
- Q-Learning:连环境模型都不知道,期望 $\mathbb{E}$ 算不了 → 用真实交互中采样到的一次 $(r, s’)$ 去逼近期望,慢慢更新。骨架不动,仍然是"即时奖励 + 折扣后继价值"。
Bellman最优方程
强化学习的最终目标不是评估某个现成策略,而是找到最优策略:在每个状态 $s$ 上,它的状态价值都 ≥ 其他任何策略。
$$\pi^* \text{ 最优} \iff V^{\pi^*}(s) \geq V^\pi(s), \quad \forall s,\ \forall \pi$$不是在平均意义上最好,也不是大部分状态上最好,而是所有状态上同时最好。
这看起来条件非常强,但是这样的策略在MDP理论中一定存在。因为逐状态取最大值这个操作,可以同时由一个全局策略实现,此策略就是每个状态都取贪心。
最优策略可能不止一个,但所有最优策略共享同一个价值函数,也就是最优价值函数:
$$V^*(s) = \max_\pi V^\pi(s), \qquad Q^*(s, a) = \max_\pi Q^\pi(s, a)$$回忆上一章的 Bellman 期望方程:
$$V^{\pi}(s) = \sum_{a} \pi(a \mid s) \sum_{s'} P(s' \mid s, a)\left[ R(s,a,s') + \gamma V^{\pi}(s') \right]$$它的第一层是 $\sum_a \pi(a \mid s)$——按策略的概率对动作取加权平均。
现在目标是需要最策略,而不再忠于任何既定策略。
站在状态 $s$,面对一堆动作,最优的做法是谁的 $Q^*$ 大就选谁,把概率全压在最好的动作上,也就是:
$$\underbrace{\sum_a \pi(a \mid s)(\cdots)}_{\text{期望方程:按策略平均}} \quad\longrightarrow\quad \underbrace{\max_a (\cdots)}_{\text{最优方程:直接挑最好的}}$$而后面两层随机,即环境转移和回报都无法控制,因此依旧平均。因此,Bellman 最优方程的状态价值版为:
$$V^*(s) = \max_{a} \sum_{s'} P(s' \mid s, a)\left[ R(s,a,s') + \gamma V^*(s') \right]$$动作价值版:
$$Q^*(s, a) = \sum_{s'} P(s' \mid s, a)\left[ R(s,a,s') + \gamma \max_{a'} Q^*(s', a') \right]$$也就是说:一个状态的最优价值 = 最优动作的动作价值。
$$V^*(s) = \max_a Q^*(s, a)$$期望方程是线性方程组,$N$ 个方程可以直接解。但是最优方程里有max,不是线性运算,不再可以直接解出,但不动点迭代的方法仍然可用。
强化学习算法的分类
打开任何一个强化学习算法列表,扑面而来的却是一堆缩写:DQN、PPO、SAC、AlphaZero……它们之间是什么关系?
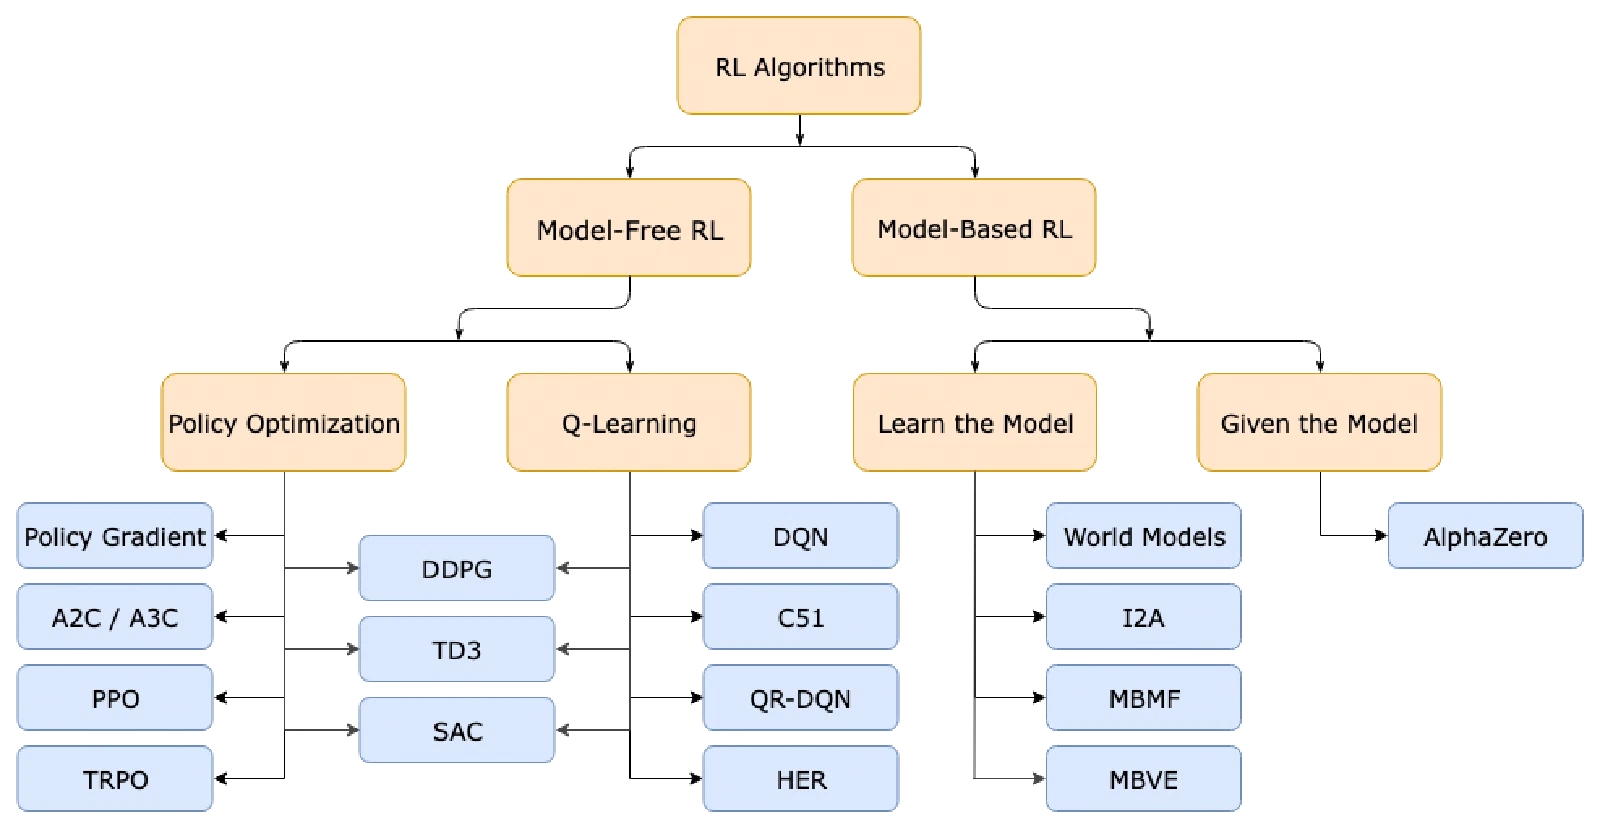
是否有模型
不同强化学习算法最重要的区分点之一就是 智能体是否能完整了解或学习到所在环境的模型。
有模型学习(Model-Based) 的优势很直接:智能体能够 提前考虑来进行规划,走到每一步的时候,都提前尝试未来可能的选择,然后明确地从这些候选项中进行选择。其中最出名的是AlphaZero。
但其缺点也很直接:真实世界的模型往往拿不到,只能从经验中学习,而学出来的模型与真实模型存在误差。而这种误差会导致智能体在学习到的模型中表现很好,但在真实的环境中表现得不好(甚至很差)。
免模型学习(Model-Free) :不预测环境,直接从真实交互的经验里学价值或策略。优缺点自然就和有模型学习相反,它牺牲了样本效率这个潜在收益,换来的是简单、好实现、好调参。
学习什么
强化学习算法另一个重要的区分点是 要学习什么。一般的主题包含:
- 策略 $\pi(a \mid s)$
- 动作价值函数 $Q(s, a)$
- 状态价值函数 $V(s)$
- 环境模型 $P$、$R$
免模型学习的两大流派
策略优化
把策略显式表示成一个带参数的函数 $\pi_\theta(a \mid s)$(比如一个神经网络),然后直接对性能目标 $J(\pi_\theta)$ 做梯度上升,或者间接地,对性能目标的局部近似函数进行优化。
这类方法通常是 on-policy(同策略) 的:每步更新只用当前最新策略采集到的数据,旧数据作废。它们往往还会顺带学一个 $V^\pi(s)$ 的近似,用来评估当前策略、指导更新方向。
基于策略优化的方法举例:
Q-Learning
不直接学策略,而是学最优动作价值函数的近似 $Q_\theta(s, a) \approx Q^*(s, a)$,训练目标来自 Bellman 方程。
学出 $Q^*$ 之后,策略就可以直接使用此方程得出:
$$a(s) = \arg\max_a Q_\theta(s, a)$$这类方法通常是 off-policy(异策略) 的:更新时可以用任意时刻采集的旧数据,不管当时智能体在怎么探索。
基于 Q-Learning 的方法
融合方法
可以同时学习一个策略和一个Q函数。
有模型学习的两大流派
模型已知
模型已知(Given the Model):转移和奖励函数直接给出。
- 纯规划 :这种最基础的方法,从来不显示的表示策略,而是纯使用规划技术来选择行动,例如 模型预测控制 (model-predictive control, MPC)。在模型预测控制中,智能体每次观察环境的时候,都会计算得到一个对于当前模型最优的规划,这里的规划指的是未来一个固定时间段内,智能体会采取的所有行动(通过学习值函数,规划算法可能会考虑到超出范围的未来奖励)。智能体先执行规划的第一个行动,然后立即舍弃规划的剩余部分。计划赶不上变化,就每次都重新计划。
- Expert Iteration(专家迭代):让规划器(如蒙特卡洛树搜索)当"专家",它给出的动作比当前策略好;再更新策略去模仿专家。如此循环。AlphaZero 就是这个范式,我们随后要讲的动态规划(策略迭代、值迭代)也在这里。
模型学习(Learn the Model):先学出一个近似模型,问题变成这个有偏差的模型如何使用。
- 数据增强:用模型生成假数据补充真实经验。World Models 全部用假数据来训练智能体,所以被称为:“在梦里训练”。
- 把规划嵌进策略:直接把规划程序作为策略的子程序,这样在基于任何免模型算法训练策略输出的时候,整个规划就变成了策略的附属信息。
动态规划DP
DP:将复杂问题分解为若干子问题,先求解子问题,并保存它们的解,在需要时直接利用,从而避免重复计算,最终得到整体问题的解。动态规划通常只适用于状态空间较小且离散的情形,否则存储和计算都会变得不可行。
Bellman 方程天生就是这个结构:$V(s)$ 用 $V(s’)$ 表示,大问题(从起点出发的价值)由小问题(后继状态的价值)拼成。
DP算法显然需要已知环境模型(model-based),也就是状态转移概率$p(s’,r|s,a)$和奖励函数$R(s,a)$才能进行计算。
策略迭代
策略迭代:先客观评价现状,再针对评价改进,改完再评价,直到无法改进。
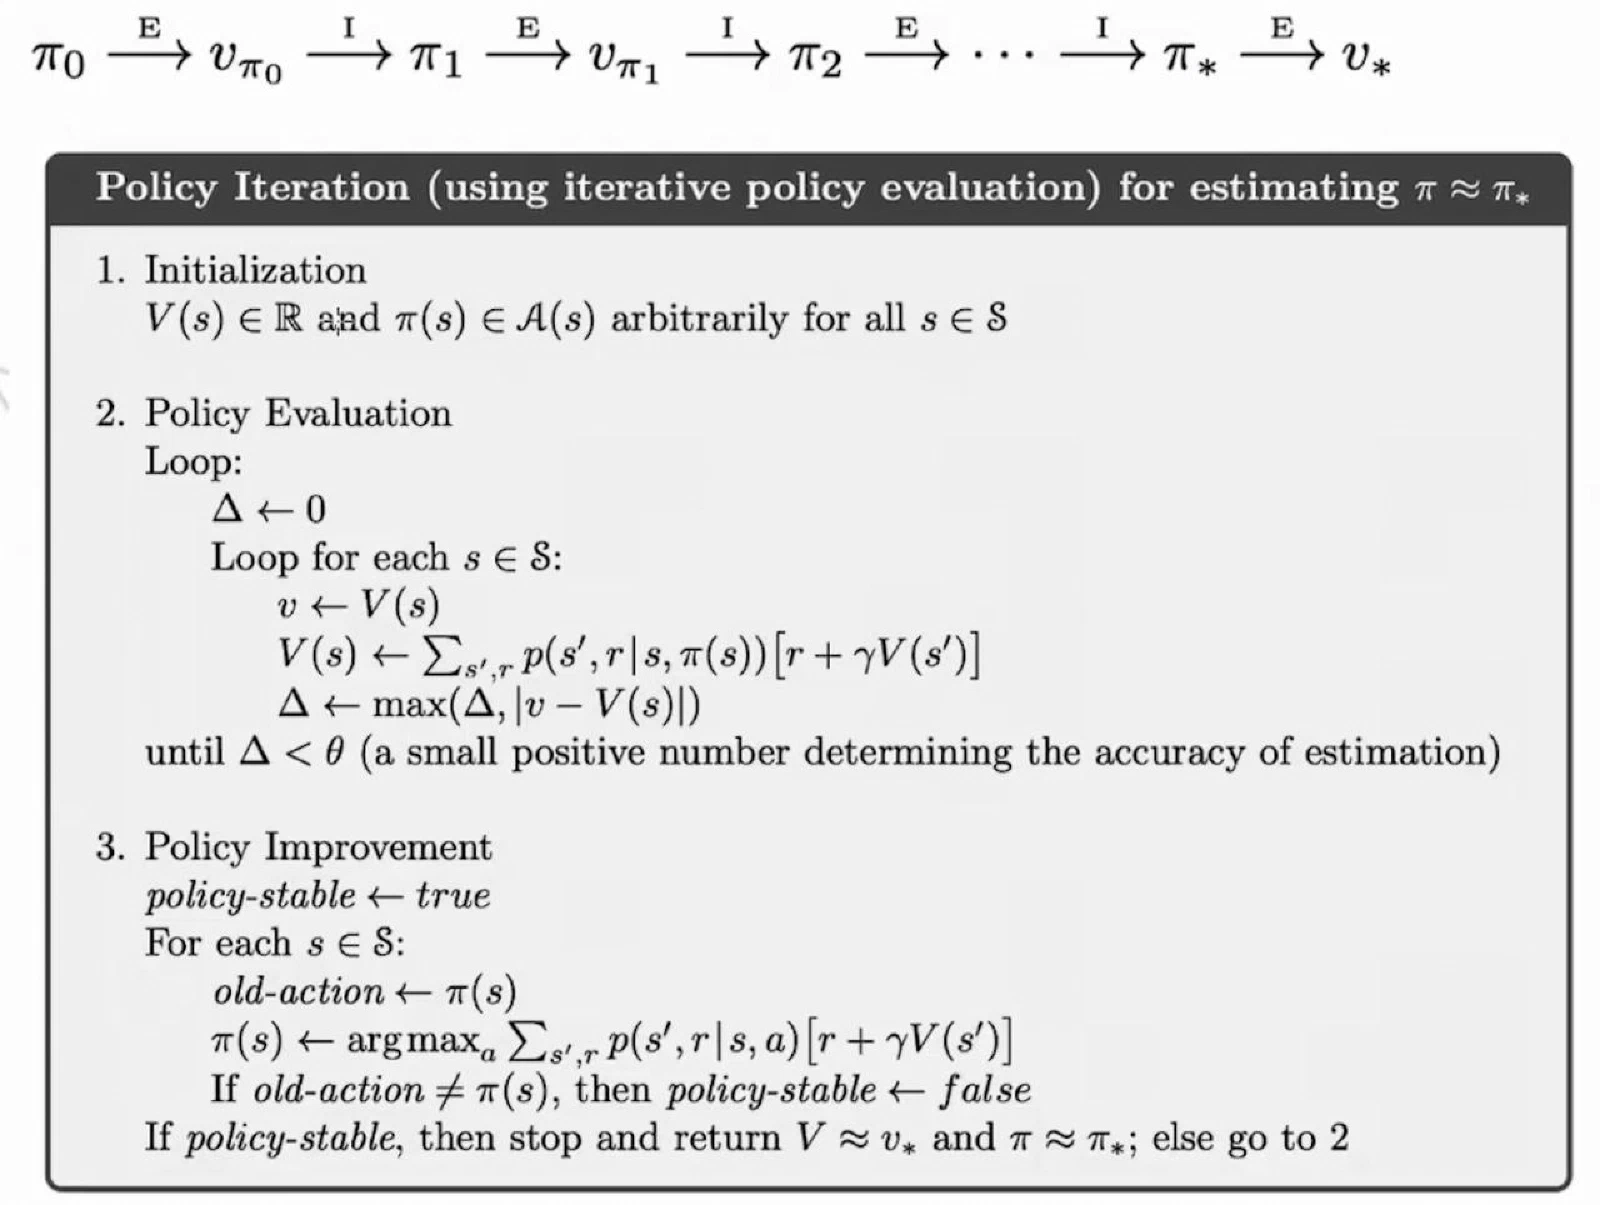
策略评估
把策略 $\pi$ 固定住,求解价值函数。我们这里使用不动点方程迭代求解:
$$V_{k+1}(s) \leftarrow \mathbb{E}_\pi\big[\, r + \gamma V_k(s') \,\big|\, s \,\big]$$反复刷新,直到前后两轮的价值差小于一个阈值,认为收敛。
策略提升
有了 $V^\pi$,就能给每个状态下的每个动作计算:
$$Q^\pi(s, a) = \sum_{s'} P(s' \mid s, a)\left[ R(s,a,s') + \gamma V^\pi(s') \right]$$然后贪心:在每个状态,把动作换成 $Q^\pi$ 最大的那个:
$$a^* = \arg\max_a Q^\pi(s, a)$$有的笔记写成 $\pi = \arg\max_\pi, \sum_a \pi(a|s) Q^\pi(s,a)$,本质相同,也就是在所有可能的动作分布里,让期望 $Q$ 最大的分布,就是把全部概率压在 $Q$ 最大的动作上。
对于有限 MDP,策略迭代在有限步内一定收敛到最优策略。因为策略空间有限,且每次改进都严格变好,不会循环。
停止条件
策略不再改变时停止。 此时提升步对所有状态都有 $\pi(s) = \arg\max_a Q^\pi(s,a)$,代回去恰好就是 Bellman 最优方程——当前策略已经满足 BOE,它就是最优策略。
V和$\pi$的更新是交替进行的,其中V的更新由于要进行多次迭代,速度会比较慢,可以通过适当放宽收敛标准,减少迭代次数;而$\pi$的更新直接贪心,速度比较快。
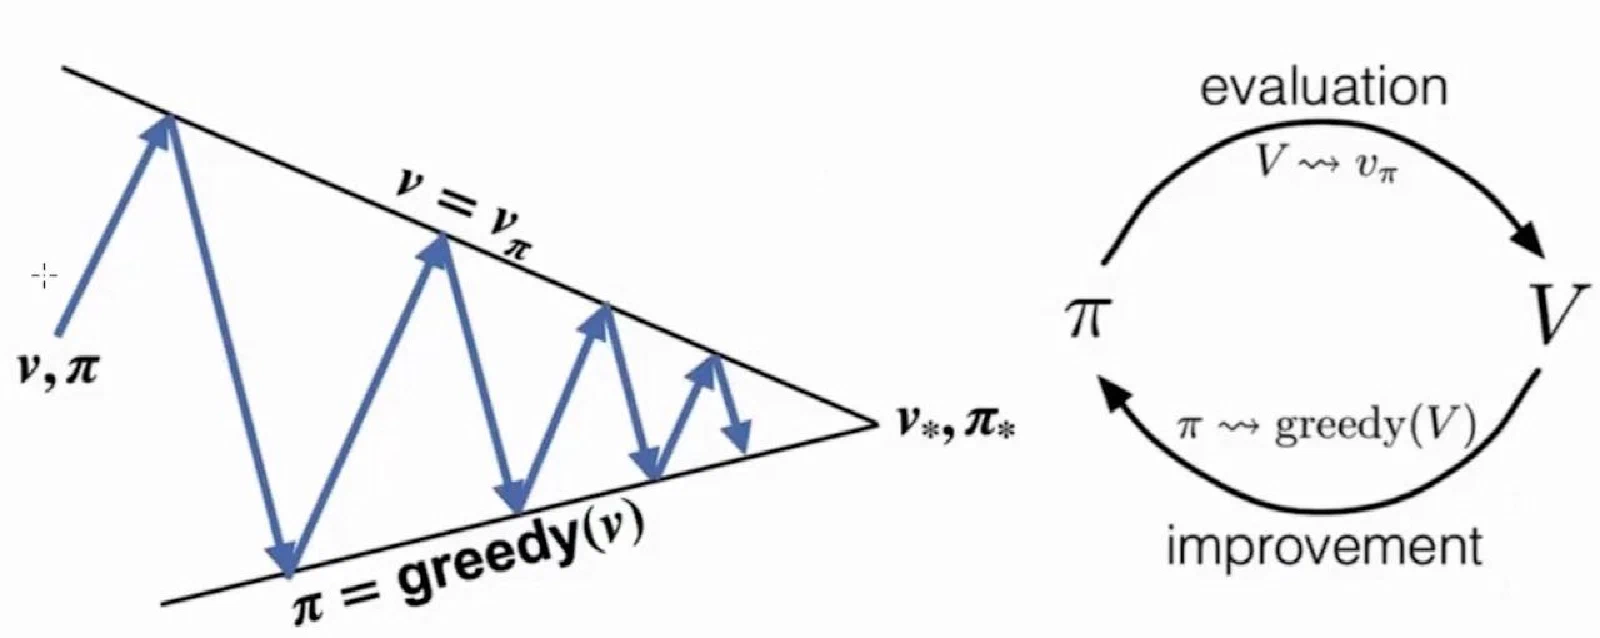
值迭代
由于策略迭代的两个步骤的成本不对称:评估要迭代很多轮,慢;提升只是查表取 max,快。因此工程上经常会放松评估的标准。把它推到极端:评估只做一轮就提升。也就是值迭代。
值迭代(Value Iteration):每个状态只刷新一次价值,就立刻用新价值贪心。两步合并成一步:
$$V_{k+1}(s) \leftarrow \max_a \sum_{s'} P(s' \mid s, a)\left[ R(s,a,s') + \gamma V_k(s') \right]$$这就是 Bellman 最优方程把等号改成赋值。其实就是Bellman最优算子$T$的作用:
$$V_{k+1}=TV_k$$它不再对应任何具体策略的评估,而是直接向 $V^*$ 逼近。
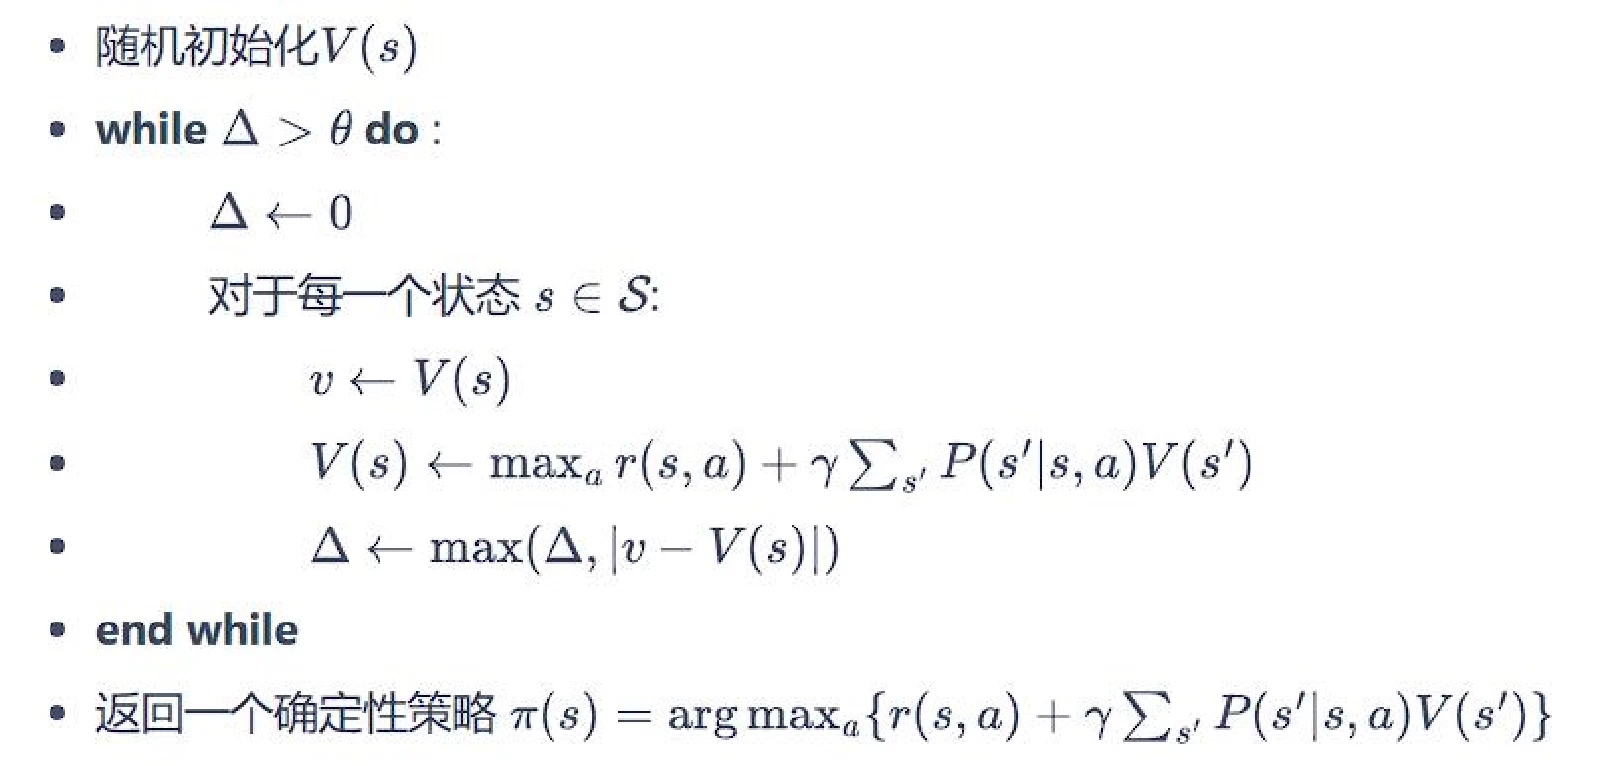
对比策略迭代和价值迭代算法:
| 维度 | 价值迭代 | 策略迭代 |
|---|---|---|
| 更新对象 | 直接优化价值函数,隐式更新策略 | 显式维护并交替优化策略与价值函数 |
| 迭代方式 | 单阶段迭代(仅更新价价值函数) | 两阶段循环(策略评估 + 策略优化) |
| 实现复杂度 | 实现简单,无需显式维护策略 | 需分别实现策略评估和改进,复杂度较高 |
| 适用场景 | 状态空间较大时更高效 | 策略变化较快时可能更有效 |
两者是同一个思想(评估-提升交替)的两个极端,中间的折中(评估几轮后提升)统称广义策略迭代(GPI)。
蒙特卡洛方法MC
第三章的动态规划有两个前提:环境模型 $P(s’, r \mid s, a)$ 完全已知,且状态空间有限。然而在大多数实际问题中,这两个前提都不成立——我们既写不出转移概率,也数不完所有状态。
从本章开始,我们转向无模型(model-free)方法:不再假设知道环境的内部规律,而是让智能体与环境真实交互,从采集到的经验数据中学习。
大数定律
回顾价值函数的定义:
$$V^\pi(s) = \mathbb{E}_\pi[\,G_t \mid s_t = s\,]$$动态规划的做法是把这个期望展开:用已知的 $P$ 和 $R$ 对所有可能的转移加权求和。模型未知时,展开无法做到。
但大数定律告诉我们:对一个随机变量重复独立采样,样本均值随着样本量增加而收敛到它的期望。掷一枚均匀的骰子,点数期望是 $3.5$;不需要知道"均匀"这个性质,只要掷上千次取平均,结果就会逼近 $3.5$。
依据大数定理,对于随机变量X,给定N个iid采样的样本${ x_j }{j=1}^N$, 则$\bar{x} = \frac{1}{N} \sum{j=1}^{N} x_j$可以视为$E(X)$的无偏估计。由大数定理可知,可以用样本均值估计期望,假设$g_1,…,g_n$是多个episode得到的n个s状态的累计回报,则$V(s) = \frac{g_1 +…+ g_n}{n}$是$G_t$的无偏估计。
于是估计 $V^\pi(s)$ 的流程变为:按策略 $\pi$ 与环境交互,每当到达状态 $s$,就记录从 $s$ 出发到回合结束实际获得的回报 $G_t$;积累大量回合后,对这些回报取平均,即为 $V^\pi(s)$ 的估计。
蒙特卡洛策略评估
基本流程
蒙特卡洛评估适用于回合制(episodic)任务——交互在有限步内终止(如一局棋分出胜负),因为只有回合结束,回报 $G_t$ 才有确定的值。
对每个状态 $s$,流程如下:
- 按策略 $\pi$ 生成一个完整回合:$s_0, a_0, r_1, s_1, a_1, \dots, s_T$;
- 对回合中出现过的每个状态 $s$,计算从它之后到回合结束的回报 $G_t$;
- 把 $G_t$ 存入 $s$ 的样本列表;
- 重复足够多的回合后,$V(s) \approx$ 样本列表的平均值。
首次访问与每次访问
同一状态在一个回合中可能出现多次,如何处理?以 $\gamma = 1$ 的一条轨迹为例:
$$s \xrightarrow{r=0} a \xrightarrow{r=1} s \xrightarrow{r=1} a \xrightarrow{r=1} \text{终止}$$状态 $s$ 出现了两次。从第一次出现算起,回报为 $0+1+1+1=3$;从第二次出现算起,回报为 $1+1=2$。
- 首次访问(first-visit):每个回合中,每个状态只记录第一次出现对应的回报。本例中 $s$ 只得到一个样本 $3$;
- 每次访问(every-visit):每次出现都记录。本例中 $s$ 得到两个样本 $3$ 和 $2$,平均为 $2.5$。
两种做法在回合数趋于无穷时都收敛到真实价值;首次访问的样本彼此独立,理论分析更简洁,实践中也更常用。下文均采用首次访问。
增量式更新
维护样本列表再求平均不必真的存下所有历史样本。均值可以写成增量形式:设已有 $N-1$ 个样本的均值 $V_{N-1}$,新样本来临时,
$$V_N = V_{N-1} + \frac{1}{N}\big(G_N - V_{N-1}\big)$$新估计 = 旧估计 + 步长 ×(新样本 − 旧估计)。括号里的差值可以看作"新样本带来的意外":样本比预期高,估计就上调一点;反之下调。
以回报样本序列 $2,\ 5,\ 2,\ 3$ 为例,逐步更新:
| 样本数 $N$ | 新样本 $G_N$ | 更新后 $V_N$ |
|---|---|---|
| 1 | 2 | 2.0 |
| 2 | 5 | $2 + \frac{1}{2}(5-2) = 3.5$ |
| 3 | 2 | $3.5 + \frac{1}{3}(2-3.5) = 3.0$ |
| 4 | 3 | $3.0 + \frac{1}{4}(3-3.0) = 3.0$ |
估计值在样本的扰动下逐步稳定。
把随 $N$ 缩小的步长 $\frac{1}{N}$ 换成固定步长 $\alpha$,就得到下一章时序差分方法的更新形态。
策略评估到策略提升
评估只是手段,目标是找到最优策略。按照广义策略迭代(GPI)的框架,评估之后要做策略提升,但无模型环境下出现两个新问题。
为什么必须估计动作价值 $Q$,而不是状态价值 $V$
模型已知时,有了 $V$ 就能提升策略:逐个动作计算 $\sum_{s’} P(s’|s,a)[R + \gamma V(s’)]$,取最大即可。但这一步用到了 $P$——模型未知时,仅知道"各状态值多少",无法回答"哪个动作更好",因为不知道每个动作的下一步。
解决办法是直接估计动作价值函数 $Q^\pi(s, a)$:把评估对象从状态换成"状态–动作对",其余流程不变——记录每次在 $s$ 执行 $a$ 之后的回报并取平均。有了 $Q$,提升策略不再需要模型:
$$a^*(s) = \arg\max_a Q(s, a)$$探索问题与 ε-贪心策略
假设某个动作当前估计的 $Q$ 值偏低,贪心策略便永远不会再选它;而它的真实价值可能很高,只是早期样本太少、估计不准。一旦停止尝试,错误估计就永远没有机会被修正。
这就是探索(exploration)与利用(exploitation)的矛盾。
一个简单而常用的折中是 ε-贪心(ε-greedy)策略:以大概率选当前最优动作,以小概率 $\varepsilon$ 在所有动作中均匀随机选择:
$$\pi(a \mid s) = \begin{cases} 1 - \varepsilon + \dfrac{\varepsilon}{|\mathcal{A}|}, & a = \arg\max_{a'} Q(s, a') \\[6pt] \dfrac{\varepsilon}{|\mathcal{A}|}, & \text{其他动作} \end{cases}$$只要 $\varepsilon > 0$,每个动作都有非零概率被选中,随着样本积累,所有动作的 $Q$ 估计都会不断改进。若让 $\varepsilon$ 随时间逐渐衰减到 $0$(例如 $\varepsilon_t = 1/t$),策略将逐步收敛到贪心策略,同时保证充分的探索。这一条件称为 GLIE(在极限中贪心、无限次探索),是蒙特卡洛控制收敛到最优策略的理论保障。
蒙特卡洛控制算法
下面的策略评估伪代码是Every-visit的,采取倒序遍历所有episode,计算得到每一个时刻的奖励值,分别放到对应状态的集合中,计算每一个状态的累计回报来估计真实的V(s)。被访问次数多的状态计算出的V(s)越接近真实。
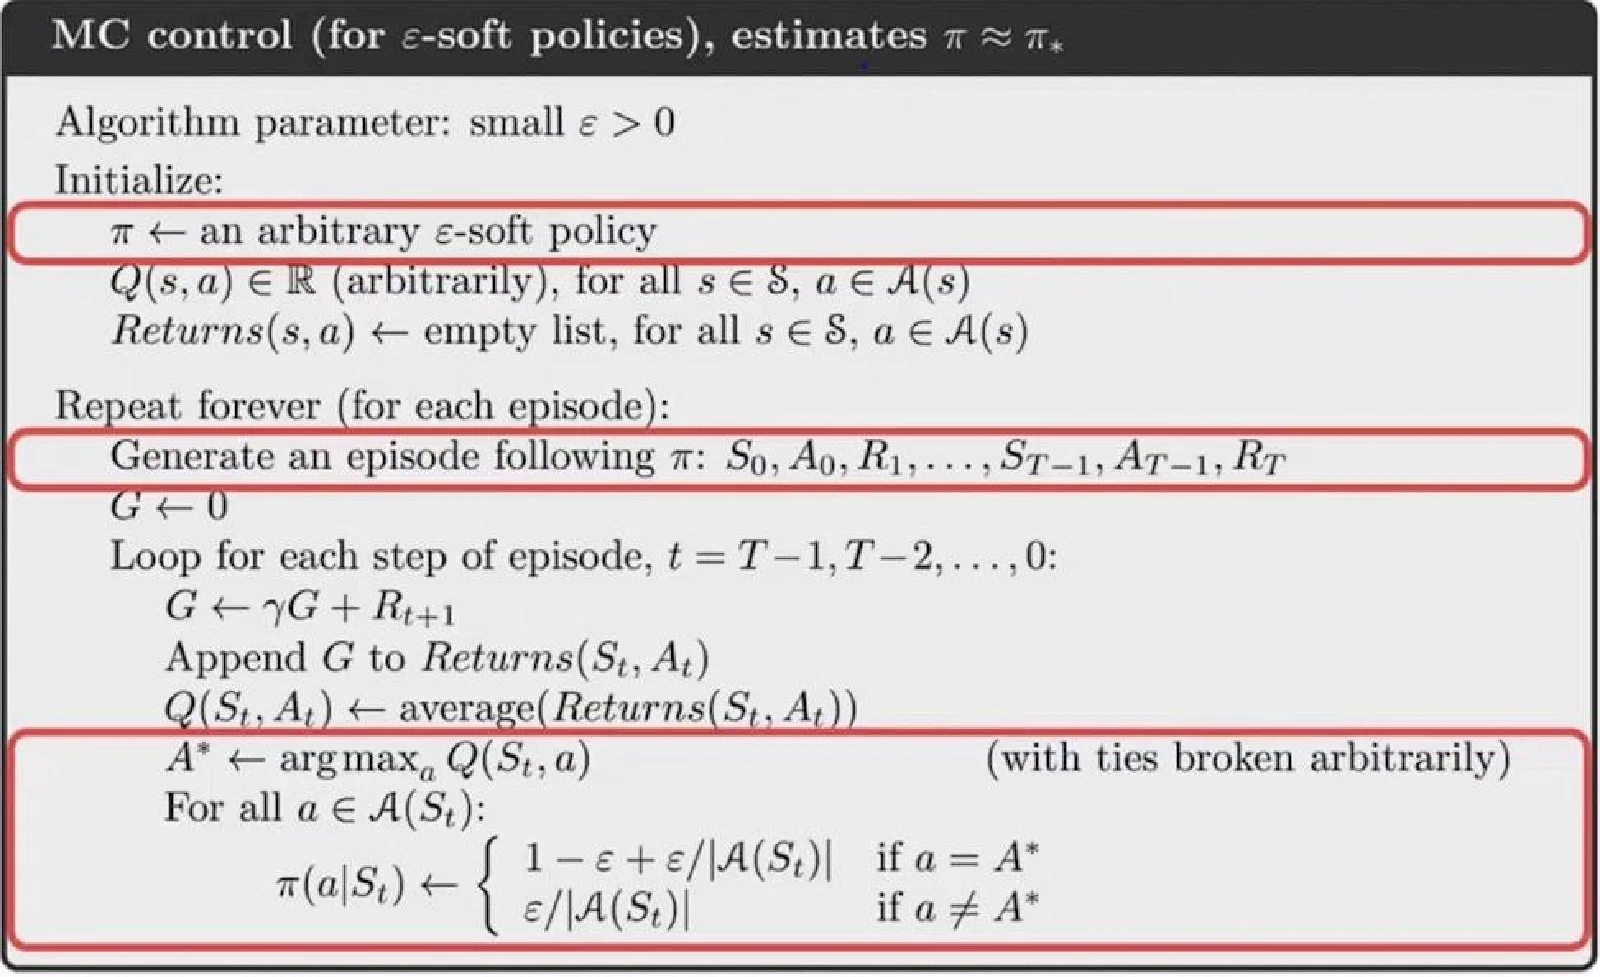
和策略迭代的结构完全一致,只是评估由解Bellman方程变为采样平均,提升的手段从贪心算法变成ε-贪心。
优点:
- 无需模型:只需要能与环境交互(或有一个能模拟交互的模拟器);
- 估计无偏:回报的样本均值直接收敛到真实期望,估计误差不依赖任何近似假设;
- 逐状态独立:每个状态的价值估计只依赖经过该状态的回报,不依赖其他状态的估计是否准确——可以只评估关心的状态。
局限:
- 必须等到回合结束:回报 $G_t$ 只有终局才能确定,因此无法在线更新,也不适用于无终止的持续型任务;
- 方差较大:$G_t$ 是整条轨迹上随机性的总和,单次样本波动剧烈,收敛需要大量回合。
时序差分算法TD
动态规划用模型精确计算期望,但要求模型已知;蒙特卡洛用样本平均逼近期望,但必须等到回合结束。本章的时序差分(Temporal-Difference, TD)方法取两者之长:像蒙特卡洛一样从经验中采样,又像动态规划一样利用 Bellman 方程的自举结构。
一步估计TD(0)
回顾两种方法对状态价值的更新目标。蒙特卡洛的更新是:
$$V(s_t) \leftarrow V(s_t) + \alpha\,\big[\, \underbrace{G_t}_{\text{MC 目标}} - V(s_t) \,\big]$$其中 $G_t$ 是完整的实际回报,只有回合终止后才能算出来。而 Bellman 方程告诉我们 $G_t = r_{t+1} + \gamma V(s_{t+1})$——如果我们已经有一个尚不准确但可用的估计 $V(s_{t+1})$,就可以用它代替遥不可及的 $G_t$,构造出只需要一步的目标:
$$V(s_t) \leftarrow V(s_t) + \alpha\,\big[\, \underbrace{r_{t+1} + \gamma V(s_{t+1})}_{\text{TD 目标}} - V(s_t) \,\big]$$这就是 TD(0) 的更新式。逐符号看:
- $r_{t+1} + \gamma V(s_{t+1})$:TD 目标。它是这一步实际拿到的奖励 + 对后继状态价值的当前估计。Bellman方程变成了采样版本。
- $\delta_t = r_{t+1} + \gamma V(s_{t+1}) - V(s_t)$:TD 误差,即"新信息"与"旧估计"之差。它是整个方法的引擎:误差为正,说明实际情况比预期好,上调估计;为负则下调;
- $\alpha$:固定步长。把 MC 增量式中随样本数缩小的 $\frac{1}{N}$ 换成常数 $\alpha$,得到的正是这类更新。常数步长使估计能持续跟踪环境的缓慢变化,代价是理论上的收敛需要更细致的条件。
蒙特卡洛的增量式用 $\alpha = \frac{1}{N}$,样本越多估计越难改变——这是因为环境不变,我们进行严格平均;TD 实践中常用固定的小常数 $\alpha$,使估计能持续跟踪缓慢变化的环境,代价是估计值会存在量级为 $\alpha$ 的残余波动,不会完全静止。
这种"用自己的估计来改进自己的估计"的做法称为自举(bootstrapping)。
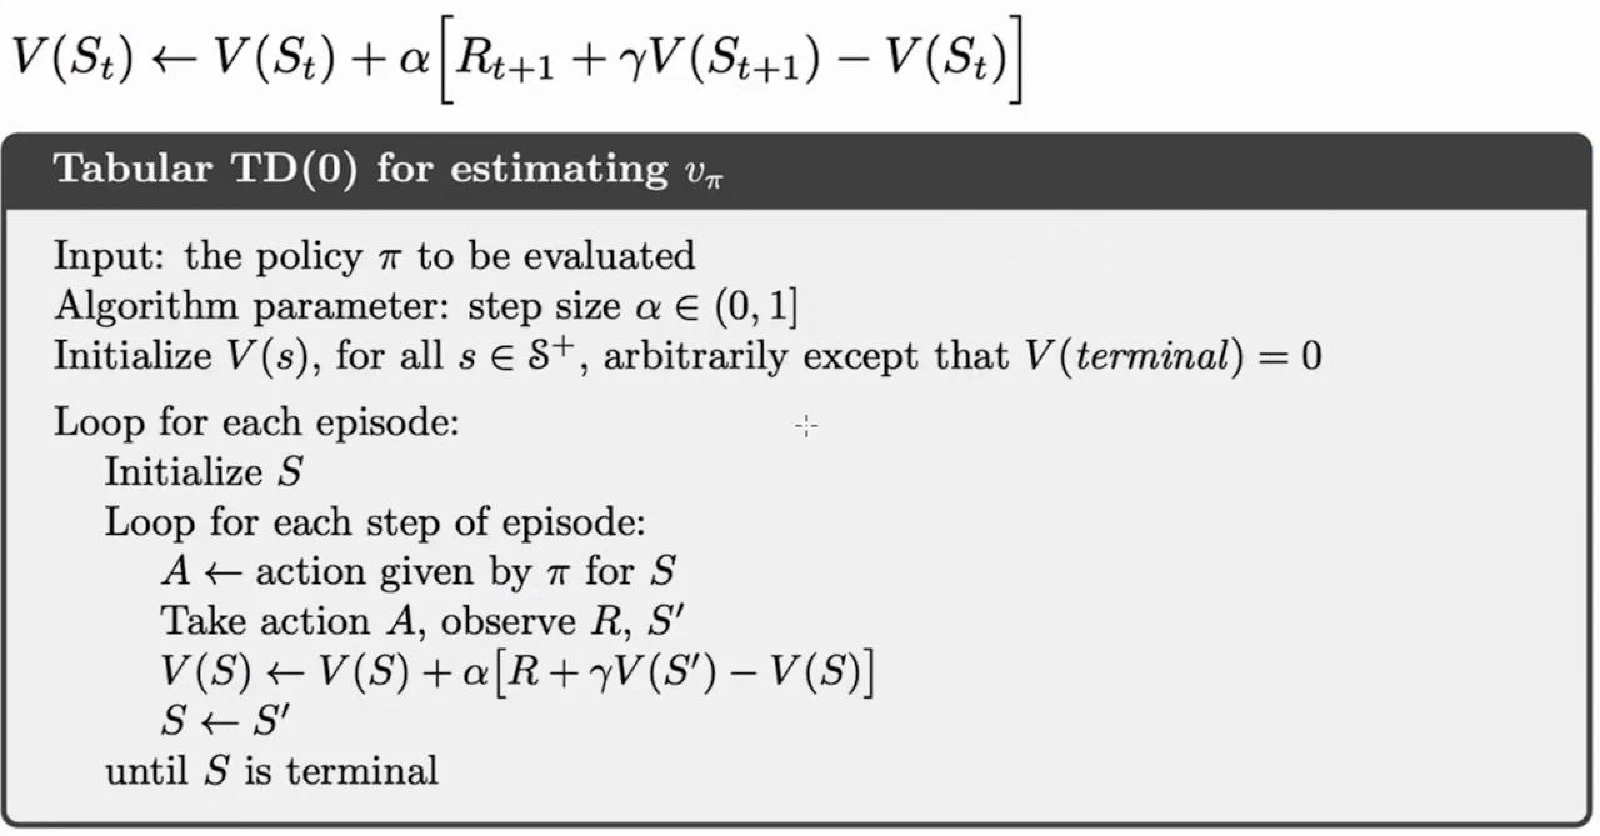
DP、MC和TD区别
DP、MC、TD 求解的是同一个问题(估计 $V^\pi$),区别可以用两个维度刻画:期望从哪里来(模型计算 vs 采样)与目标看多远(自举一步 vs 看到终局)。
| 动态规划 | 蒙特卡洛 | 时序差分 | |
|---|---|---|---|
| 期望来源 | 模型解析展开 | 采样 | 采样 |
| 更新目标 | $\mathbb{E}[r + \gamma V(s’)]$ | 完整回报 $G_t$ | $r + \gamma V(s’)$(自举) |
| 是否需模型 | 需要 | 不需要 | 不需要 |
| 是否需等终局 | 否 | 是 | 否 |
| 偏差 / 方差 | 无采样误差 | 无偏、方差大 | 有偏(自举目标不准)、方差小 |
两点说明:
- TD 的偏差是暂时的:初期目标不准导致估计有偏,但随着 $V(s’)$ 本身收敛,偏差随之消失;
- 方差差异是本质的:$G_t$ 承担整条轨迹的随机性,而 TD 目标只承担一步的随机性,因此波动小得多,实践中往往收敛更快。
从目标看多远的视角看,MC 与 TD(0) 是一个光谱的两个端点:看 $n$ 步再自举,就是 $n$ 步 TD;把各步长按权重混合,就是 TD($\lambda$)。
Sarsa:TD控制
从评估走向控制。先做转换:把估计对象从 $V$ 换成 $Q$(无模型时只有 $Q$ 能支撑策略提升)。TD 更新直接搬过来:
$$Q(s_t, a_t) \leftarrow Q(s_t, a_t) + \alpha\,\big[\, r_{t+1} + \gamma Q(s_{t+1}, a_{t+1}) - Q(s_t, a_t) \,\big]$$注意目标里出现了 $Q(s_{t+1}, a_{t+1})$——更新依赖一次转移的完整五元组 $(s_t, a_t, r_{t+1}, s_{t+1}, a_{t+1})$,算法因此得名 SARSA。
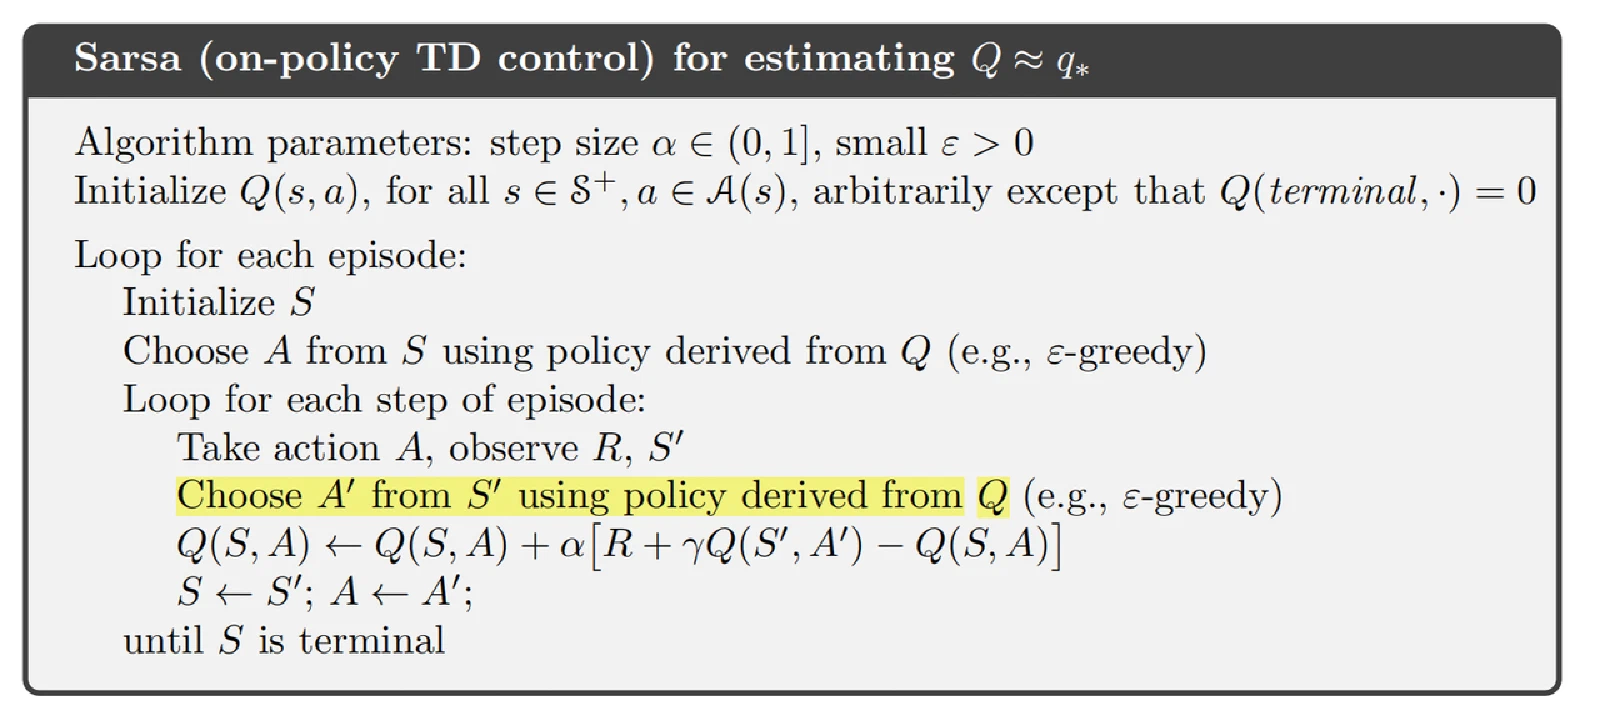
更新使用的 $a’$ 是行为策略(ε-贪心)实际选出的动作。这意味着 SARSA 评估的是"包含探索行为在内的当前策略"的价值——它在提升策略的同时,诚实地把探索的代价也算进账里。因此 SARSA 是 on-policy(同策略) 算法,学的就是正在执行的策略。
Q-Learning
SARSA 更新式中的 $Q(s_{t+1}, a_{t+1})$ 换成 $\max_{a’} Q(s_{t+1}, a’)$:
$$Q(s_t, a_t) \leftarrow Q(s_t, a_t) + \alpha\,\big[\, r_{t+1} + \gamma \max_{a'} Q(s_{t+1}, a') - Q(s_t, a_t) \,\big]$$就得到 Q-Learning。
- 目标不再依赖实际采取的下一个动作,而是假设下一步按最优动作行动,无论行为策略实际选了什么;
- 因此它估计的是最优动作价值 $Q^*$,而非当前策略的 $Q^\pi$;学到的目标策略与产生数据的行为策略分离,这就是 off-policy(异策略);
这个目标正是 Bellman 最优方程的采样版本。
- on-policy:行为策略和目标策略是同一个策略,例如Sarsa,目标策略更新时必须使用来自当前行为策略采样得到的五元组$(s, a, r, s’, a’)$。
- off-policy:行为策略和目标策略不是同一个策略,例如Q-learning,更新目标策略时用的四元组$(s,a,r,s’)$可以来自行为策略,而$a’$是通过目标策略执行$\mathop{\max}\limits_{a } Q(s’, a)$得到的。
| 特征 | On-Policy | Off-Policy |
|---|---|---|
| 数据来源 | 必须由当前策略生成 | 可使用历史数据或其他策略生成的数据 |
| 样本效率 | 低(每次更新后旧数据失效) | 高(可重复利用旧数据) |
| 策略更新与探索的耦合 | 强耦合(策略更新后必须重新收集数据) | 解耦(行为策略可独立设计) |
| 偏差与方差 | 低偏差(数据与目标策略一致)收敛更稳定 | 高偏差(需处理策略差异,如重要性采样),收敛可能不稳定 |
| 实现复杂度 | 较简单 | 较复杂(需处理重要性采样比率等) |
| 应用场景 | 适用于需要实时适应环境变化、对策略稳定性要求较高的场景,如一些实时控制任务 | 适用于数据丰富、需要高效利用数据的场景,如推荐系统、游戏 AI 等,也可以用于从离线数据中学习 |
| 训练速度 | 在进行目标策略更新时,不能进行数据采样,这可能会减慢训练速度 | 可并行收集数据(多个环境实例同时生成数据),进一步加速训练 |
价值函数逼近与DQN
到目前为止,所有方法——蒙特卡洛、时序差分、SARSA、Q-Learning——都隐含一个共同假设:价值函数可以存成一张表格,每个状态(或状态–动作对)占一个条目,学习就是反复修改条目里的数。本章讨论当这个假设不再成立时怎么办,并由此进入深度强化学习的第一座里程碑:DQN。
表格方法的局限
存储。 状态数量稍大,表格就放不下了:围棋的局面数约为 $10^{170}$,远超任何机器的存储能力;即便存得下,也没有足够的时间逐个访问。
泛化。 表格中每个条目独立估计,互不相关。但现实中的状态往往高度相似——棋盘上只差一子的两个局面,价值应当接近。表格方法对相似状态完全不做信息共享,每个状态都要从零学起,样本被大量浪费。
连续空间。 机器人的关节角度、车辆的时速是连续变量,根本无法枚举成表格的条目。
这三个局限指向同一个出路:用一个带参数的函数代替表格,
$$Q_\theta(s, a) \approx Q^*(s, a)$$其中 $\theta$ 是参数(例如神经网络的全部权重)。参数量通常远小于状态数;更重要的是,由于函数本身连续,参数的一次调整会同时影响一片相似状态的输出——对一个状态的学习自动惠及相似状态,泛化由此而来。
从修改表格到调整参数
表格方法的更新是对某个条目直接赋值式的拉近:
$$Q(s, a) \leftarrow Q(s, a) + \alpha\,\big[\, y - Q(s, a) \,\big]$$其中 $y$ 是更新目标(MC 用 $G_t$,TD 用 $r + \gamma V(s’)$)。函数逼近下能改的只有共享的参数 $\theta$。于是问题转化为一个标准的监督学习:让 $Q_\theta(s, a)$ 逼近目标 $y$,损失取平方误差:
$$L(\theta) = \frac{1}{2}\big(\, y - Q_\theta(s, a) \,\big)^2$$对 $\theta$ 做一步梯度下降,得到更新式:
$$\theta \leftarrow \theta + \alpha\,\big(\, y - Q_\theta(s, a) \,\big)\, \nabla_\theta Q_\theta(s, a)$$与表格更新式对比,结构完全平行:括号里仍是TD 误差(新目标与旧估计之差),只是多乘了一项 $\nabla_\theta Q_\theta$,这里采用的是梯度下降,指明更新方向。表格更新是它的特例:当每个状态有独立参数(即表格)时,$\nabla_\theta Q$ 恰好是只在一个位置为 1 的指示向量,更新就退化为只改一个条目。
一个手算示例。 设线性逼近 $Q_\theta(s) = \theta \cdot s$,当前 $\theta = 1$。在状态 $s = 1$ 处获得 TD 目标 $y = 2$。此时:
- 当前估计 $Q_\theta(1) = 1 \times 1 = 1$,TD 误差 $= 2 - 1 = 1$;
- 梯度 $\nabla_\theta Q_\theta(1) = s = 1$;
- 取 $\alpha = 0.5$,更新 $\theta \leftarrow 1 + 0.5 \times 1 \times 1 = 1.5$。
更新后 $Q_\theta(1) = 1.5$,向目标 2 靠近了一步。注意副作用:所有其他状态的估计也被同时改变了(如 $s=2$ 处从 2 变为 3)——这正是泛化的实现机制,也是误差的潜在来源:对一处的修正可能扰动别处。
半梯度(semi-gradient)说明。 TD 目标 $y = r + \gamma \max_{a’} Q_\theta(s’, a’)$ 中同样含有 $\theta$,但更新时把 $y$ 当作常数,不对它求梯度——否则梯度会穿过"目标自身",更新方向不再有明确的不动点含义。这种"目标视为常数"的做法称为半梯度,是 TD 类方法在函数逼近下的标准形式,其代价是收敛性不再有严格保证。
DQN
把 $Q_\theta$ 实例化为深度神经网络、套进 Q-Learning 框架,原则上已经完成。但直接这样做在实践中无法稳定训练,原因有两个,DQN(Mnih et al., 2013/2015)的贡献正是各给出一个对策。
经验回放
梯度下降的有效性建立在样本独立同分布的假设上。然而在线产生的交互序列
$$(s_t, a_t, r_{t+1}, s_{t+1}), (s_{t+1}, a_{t+1},r_{t+2}, s_{t+2}), \dots$$高度相关:相邻转移的状态几乎相同,且整段序列来自同一个策略的同一时期。用这样的数据连续更新,参数会被近期的局部经验主导,产生震荡甚至遗忘。
经验回放(experience replay) 的做法:把每条转移存入一个容量有限的回放缓冲区,训练时从中均匀随机抽取一个小批量进行更新。这么做可以起到以下两个作用。
- 使样本满足独立假设。在 MDP 中交互采样得到的数据本身不满足独立假设,因为这一时刻的状态和上一时刻的状态有关。非独立同分布的数据对训练神经网络有很大的影响,会使神经网络拟合到最近训练的数据上。采用经验回放可以打破样本之间的相关性,让其满足独立假设。
- 提高样本效率。每一个样本可以被使用多次,十分适合深度神经网络的梯度学习。
目标网络
TD 目标 $y = r + \gamma \max_{a’} Q_\theta(s’, a’)$ 依赖当前参数 $\theta$:每次更新不仅移动 $Q_\theta$,也移动了目标本身。目标本身就包含神经网络的输出,因此在更新网络参数的同时目标也在不断地改变,这非常容易造成神经网络训练的不稳定性。
目标网络(target network) 的做法:维护一份旧参数 $\theta^-$,目标改由它计算:
$$y = r + \gamma \max_{a'} Q(s', a'; \theta^-)$$$\theta^-$ 平时冻结,每隔固定步数才把在线网络的参数复制过来($\theta^- \leftarrow \theta$)。如果两套网络的参数随时保持一致,则仍为原先不够稳定的算法。为了让更新目标更稳定,目标网络并不会每一步都更新。
具体而言,目标网络使用训练网络的一套较旧的参数,训练网络在训练中的每一步都会更新,而目标网络的参数每隔$C$步才会与训练网络同步一次,即$\theta^- \leftarrow \theta$。这样做使得目标网络相对于训练网络更加稳定。